> For the complete documentation index, see [llms.txt](https://docs.tabiya.org/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.tabiya.org/tabiya-documentation/deutsch/unser-technologie-stack/compass/technical-overview.md).
# Technischer Überblick
### KI-Architektur
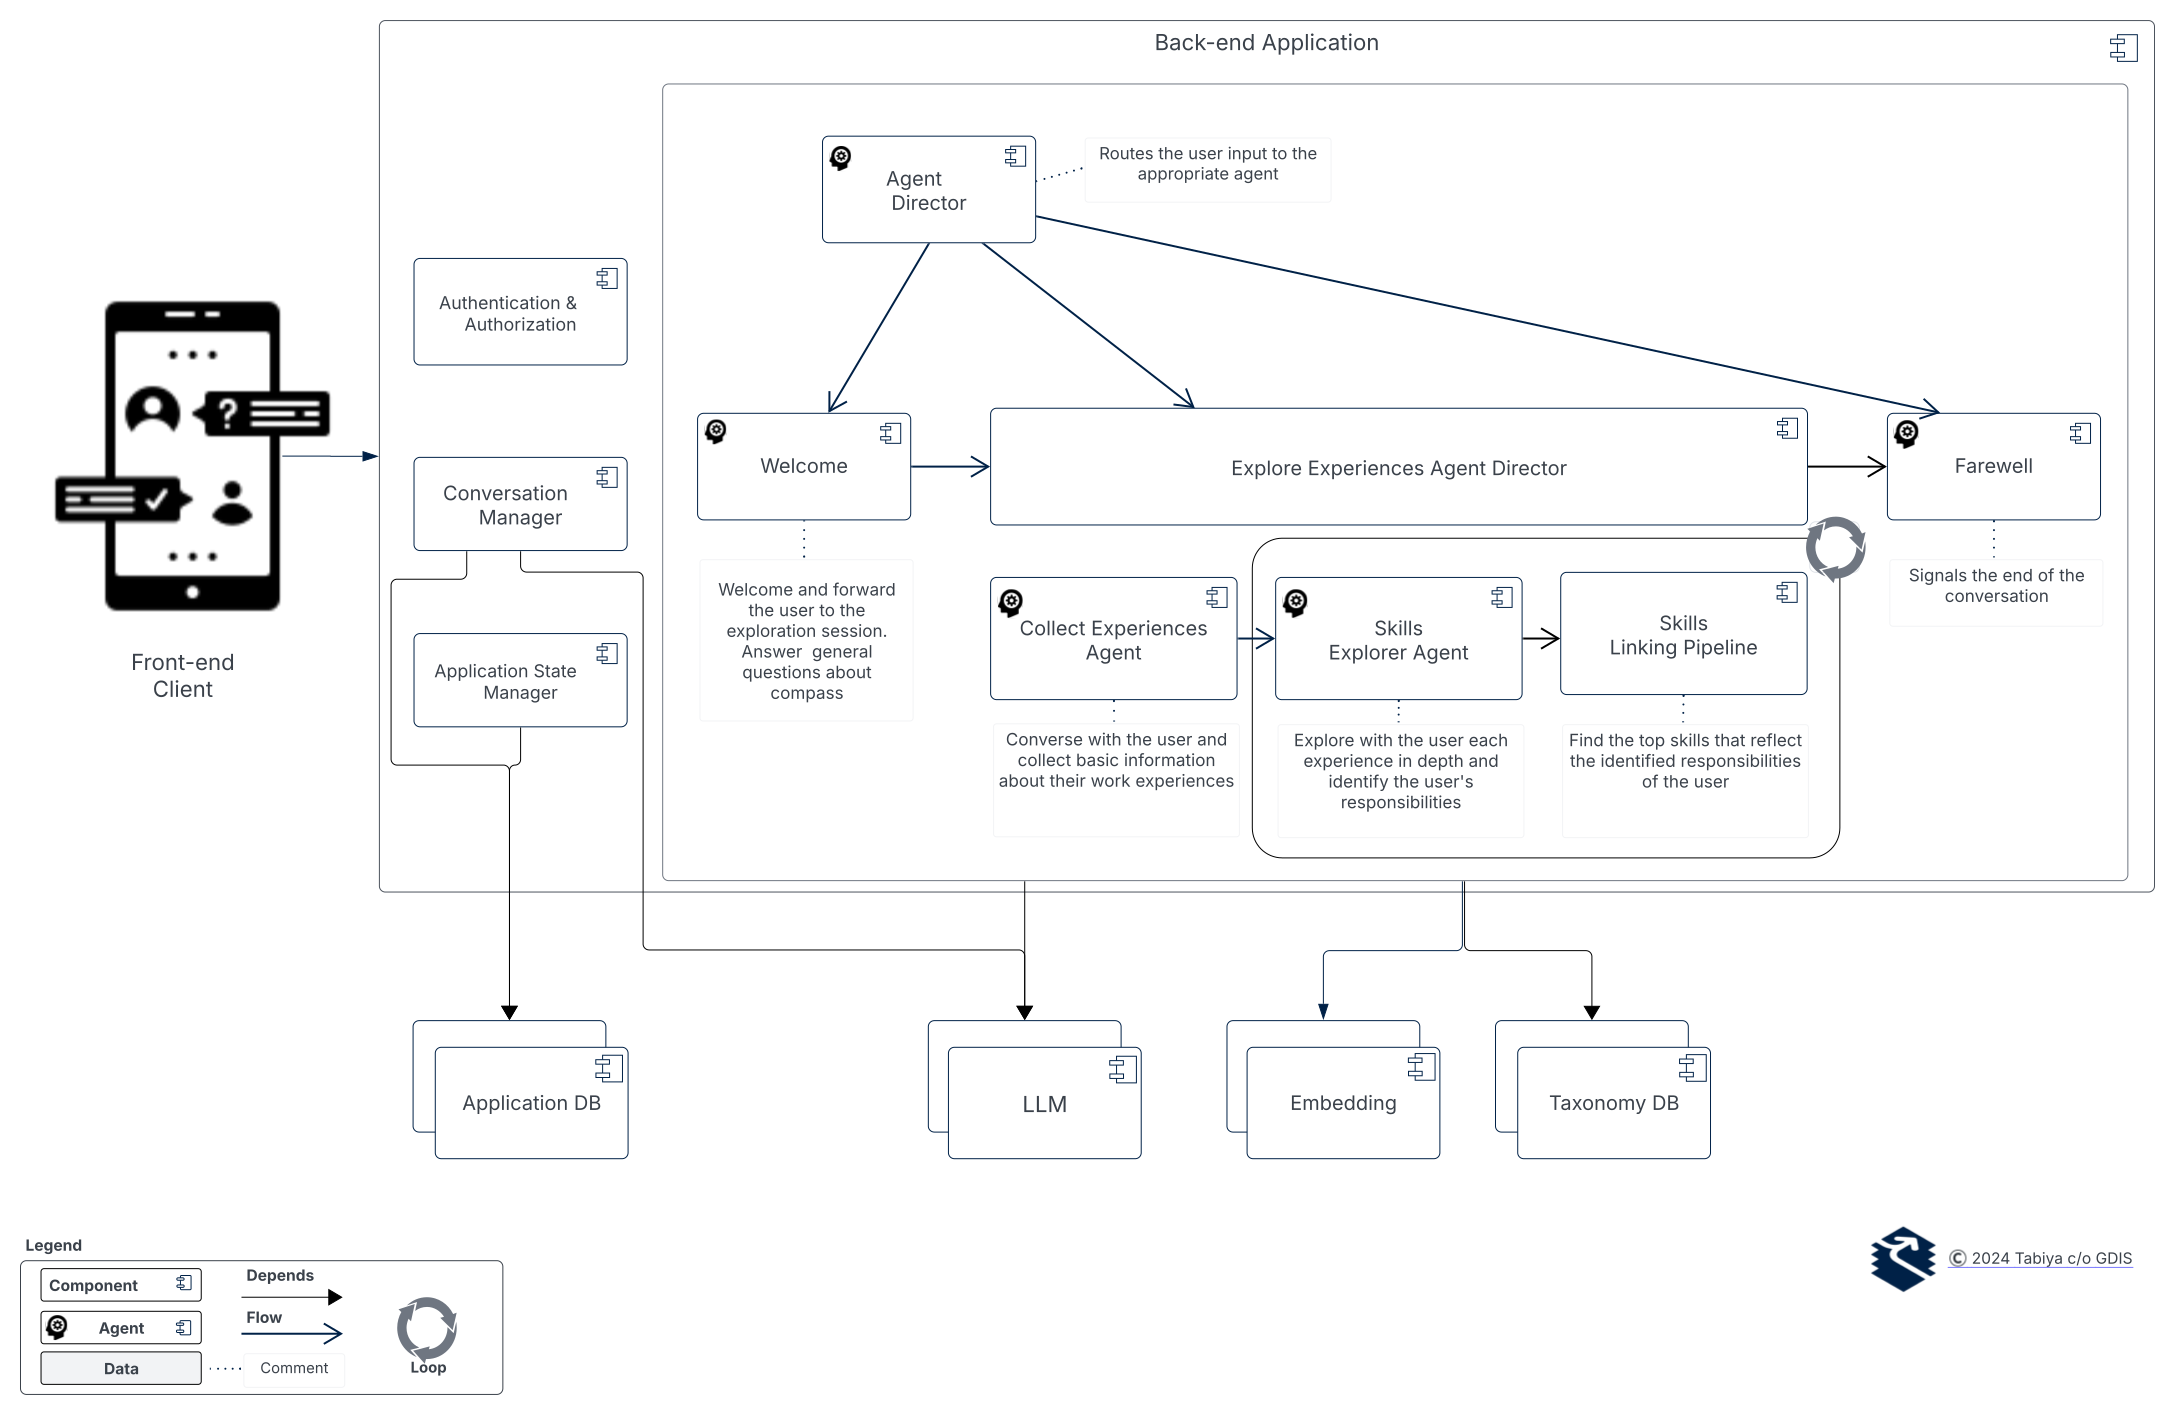
Kompass nutzt agentische Workflows, um mit Nutzern zu interagieren, Informationen zu sammeln und ihre Fähigkeiten zu identifizieren.
Kompass ahmt nach, wie ein Mensch ein Gespräch und die daraus resultierenden Aufgaben angehen würde, und fungiert als übergeordneter Agent, der sich in kleinere Agenten aufteilt, von denen jeder seine eigenen Verantwortlichkeiten und Ziele hat.
Jeder Agent innerhalb von Kompass hat eine spezifische Verantwortung und führt mehrere Aufgaben aus, um sein Ziel zu erreichen. Ein Agent könnte beispielsweise mit einem Nutzer ein Gespräch führen, um bestimmte Informationen zu sammeln, diese Informationen zu verarbeiten und sie für die Verwendung durch einen anderen Agenten aufzubereiten.
Überblick über die KI-Architektur von Kompass
Agenten behalten einen internen Zustand bei, der es ihnen ermöglicht, eine Strategie zur Erreichung ihres Ziels anzuwenden, und haben Zugriff auf den Gesprächsverlauf des Nutzers sowie auf Werkzeuge, die auf LLM-Prompts basieren (oder auch nicht). Diese Werkzeuge können für Aufgaben wie das Gespräch mit dem Nutzer, Named-Entity-Extraktion, Klassifikation oder die Transformation von Nutzereingaben verwendet werden.
Agenten werden durch eine Kombination aus Anweisungen (Prompts) und ihrem internen Zustand gesteuert. Die Prompts können je nach Zustand des Agenten variieren, um ihm bei der Erledigung seiner Aufgaben zu helfen.
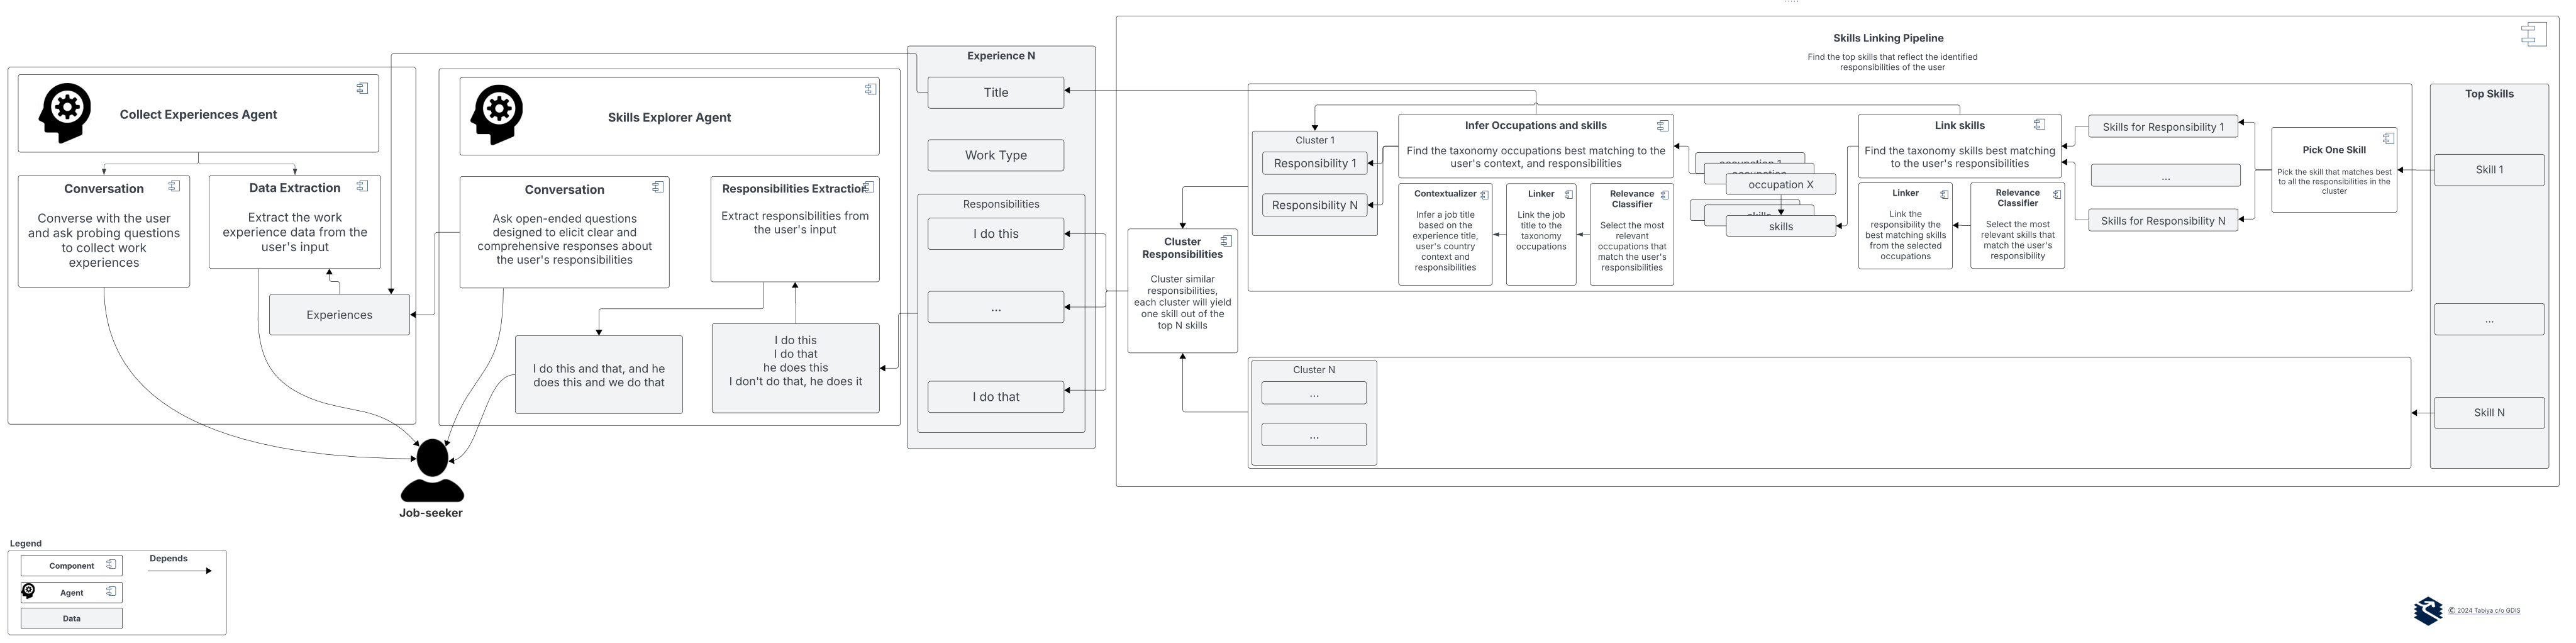
Sobald Kompass alle erforderlichen Informationen vom Nutzer gesammelt hat, verarbeitet es die Daten, um die wichtigsten Fähigkeiten des Nutzers zu identifizieren. Diese Identifizierung erfolgt über eine mehrstufige Pipeline, die verschiedene Techniken wie Clustering, Klassifikation und Entity Linking mit einer Berufe-/Fähigkeiten-Taxonomie einsetzt.
Detaillierte KI-Architektur mit der mehrstufigen Fähigkeiten-Pipeline
Kompass nutzt LLMs auf vier Arten:
1. **Dialogische Interaktion**: Anders als bei typischen Anwendungen, bei denen das LLM auf Nutzerfragen antwortet, kehrt Kompass diese Interaktion um. Es generiert Fragen, um ein **zielgerichtetes** und **fundiertes** Gespräch.
2. **Aufgaben der Verarbeitung natürlicher Sprache**: Kompass nutzt das LLM für Aufgaben wie Clustering, Named-Entity-Extraktion und Klassifikation und verarbeitet Nutzereingaben effizient, ohne dass kostspieliges und zeitaufwendiges Modelltraining oder Fine-Tuning erforderlich ist.
3. **Erklärbarkeit und Nachverfolgbarkeit**: Das LLM liefert Begründungen für bestimmte Ausgaben und ermöglicht so Erklärungen, die entdeckte Fähigkeiten mit der Eingabe des Nutzers verknüpfen. Diese Funktion, die auf einer Variante des Chain-of-Thought-Schlussfolgerns basiert, ist besonders bemerkenswert – nicht nur wegen der Fähigkeit, die sie bietet, sondern auch, weil sie ein unbeabsichtigtes Ergebnis war. Sie entstand bei dem Versuch, ein anderes Problem zu lösen: die Genauigkeit der LLM-Aufgaben zu verbessern
4. **Filterung der Taxonomie-Ausgabe**: Das LLM filtert relevante Fähigkeiten und Berufe, die mit dem ESCO-Modell verbunden sind, aus der Ausgabe des Gesprächs. Mithilfe seiner fortgeschrittenen Schlussfolgerungsfähigkeiten verarbeitet das LLM effizient große Textmengen und identifiziert die relevantesten Entitäten. Dieser Ansatz kombiniert das traditionelle Entity Linking mittels semantischer Suche mit einem auf LLMs basierenden Filter und schafft so eine hybride Lösung.
Kompass ist auf mehrere Arten fundiert und vor Halluzinationen geschützt:
* **Aufgabenzerlegung**: Kleinere, besser handhabbare Aufgaben werden einzelnen Agenten mit spezifischen LLM-Prompts zugewiesen.
* **Zustandsinduzierte Anweisungen**: Agenten nutzen ihren internen Zustand, um während der Nutzerinteraktionen gezielte Anweisungen zu erzeugen und das Gespräch auf ein bestimmtes Ziel auszurichten. Dieser Ansatz reduziert die Größe des Prompts, da nur relevante Abschnitte enthalten sind, und erhöht so die Wahrscheinlichkeit, dass das LLM den Anweisungen präzise folgt, wodurch das Risiko von Halluzinationen verringert wird.
* **Geführte Ausgabe**: Die Anweisungen sind sorgfältig formuliert, um die Wahrscheinlichkeit relevanter Antworten zu erhöhen. Zu den Techniken gehören:
* One- und Few-Shot-Lernen
* Chain-of-Thought
* Retrieval-Augmented Generation
* JSON-Schemas mit Validierung und Wiederholungsversuchen
* Anordnung der Ausgabesegmente, um sie an semantische Abhängigkeiten anzupassen
* **Zustandsleitplanken**: Wann immer möglich werden einfache, regelbasierte Entscheidungen getroffen, wodurch die Abhängigkeit vom LLM verringert und potenzielle Ungenauigkeiten minimiert werden.
* **Verankerung in der Taxonomie**: Durch die Zuordnung von Entitäten zu einer vorgegebenen Berufe-/Fähigkeiten-Taxonomie stellt Kompass sicher, dass die identifizierten Fähigkeiten in einem relevanten und genauen Bereich bleiben.
### Evaluation
Für die Evaluation von Kompass sind wir der unten beschriebenen Strategie gefolgt:
* **Gründliche Evaluation der Embeddings**: Wir haben verschiedene Strategien zur Erzeugung von Embeddings aus den Taxonomie-Entitäten gründlich evaluiert. Dabei berücksichtigten wir, welche Eigenschaften der Entitäten in die Embedding-Erzeugung einbezogen werden sollten, und bestimmten außerdem die optimale Anzahl von Entitäten, um Genauigkeit und Präzision auszubalancieren. Für die Tests verwendeten wir etablierte Datensätze aus der Literatur und erzeugten synthetische Daten, um Nutzeranfragen an Kompass zu simulieren.
* **Isoliertes Testen von Komponenten**: Die Werkzeuge jedes Agenten wurden anhand spezifischer Eingaben und erwarteter Ausgaben einzeln evaluiert. Beispielsweise wurden Klassifikationskomponenten mit bekannten Eingaben getestet, um die korrekte Vergabe von Labels zu verifizieren.
* **Skriptgesteuerte Gespräche**: Konversationsagenten wurden anhand vordefinierter Dialoge getestet, wobei die Ausgaben entweder von automatisierten Evaluatoren (anderen LLMs) oder menschlichen Prüfern bewertet wurden.
* **Simulierte Nutzerinteraktionen**: Kompass wurde in End-to-End-Szenarien getestet, indem von einem LLM gesteuerte Nutzerinteraktionen simuliert wurden. Dem simulierten Nutzer wurde anhand unserer UX evaluation und zusätzlicher Anweisungen eine Persona zugewiesen, um bestimmte interessante Fälle abzudecken. Diese Gespräche wurden anschließend hinsichtlich Qualität und Relevanz von automatisierten Evaluatoren (anderen LLMs) oder menschlichen Prüfern bewertet.
* **Nutzertests und Trace-Analyse**: In kleinerem Maßstab wurden reale Nutzertests durchgeführt. Durch die Rückverfolgung der Top-Skill-Ausgaben bis zur Eingabe des Nutzers konnten menschliche Prüfer die Leistung bestimmter Agenten innerhalb von Kompass bewerten.
### Die zentrale Rolle einer Taxonomie
Tabiyas inklusive Taxonomie spielt in Kompass eine zentrale Rolle. Sie verankert die Aufgaben des LLM, aber es gibt noch mehrere weitere Aspekte, die erwähnenswert sind:
* **Standardisierung**: Die identifizierten Fähigkeiten werden mit einer Standardtaxonomie verknüpft, was die Interpretation und den Vergleich erleichtert. Die Konzepte hinter diesen Fähigkeiten sind klar definiert und erklärbar, was eine Klärung und Disambiguierung ermöglicht.
* **Kanonisierung**: Erkundete Fähigkeiten werden mit kanonischen Namen und UUIDs aufgeführt, was eine konsistente Referenzierung über verschiedene Erfahrungen und Anwendungen hinweg ermöglicht.
* **Netzwerkstruktur**: Die Taxonomie modelliert den Arbeitsmarkt, indem sie Berufe mit Fähigkeiten verknüpft und so einen Wissensgraphen bildet, der den Nutzern zusätzliche Einblicke liefern kann.
* **Unsichtbare Ökonomie**: Die Taxonomie wurde erweitert, um Aktivitäten aus der unsichtbaren Ökonomie einzubeziehen, wodurch junge Frauen und Personen, die zum ersten Mal eine Beschäftigung suchen, der Einstieg in den Arbeitsmarkt erleichtert wird.
* **Lokalisierung**: Eine Taxonomie kann den spezifischen Kontext eines Landes berücksichtigen. Dazu gehören Berufe, die nur in bestimmten Regionen vorkommen, alternative Bezeichnungen für Berufe, die regionsspezifisch sind, und unterschiedliche Kompetenzanforderungen für denselben Beruf in verschiedenen Ländern.
* **Klassifikation der Arbeitsart**: Alle Erfahrungen werden in vier Typen eingeteilt (Lohnarbeit, Selbstständigkeit, unbezahlte Praktikantentätigkeit und unsichtbare Arbeit), was eine gezieltere Erkundung der Fähigkeiten der Arbeitssuchenden ermöglicht.
### Überblick über den technischen Stack
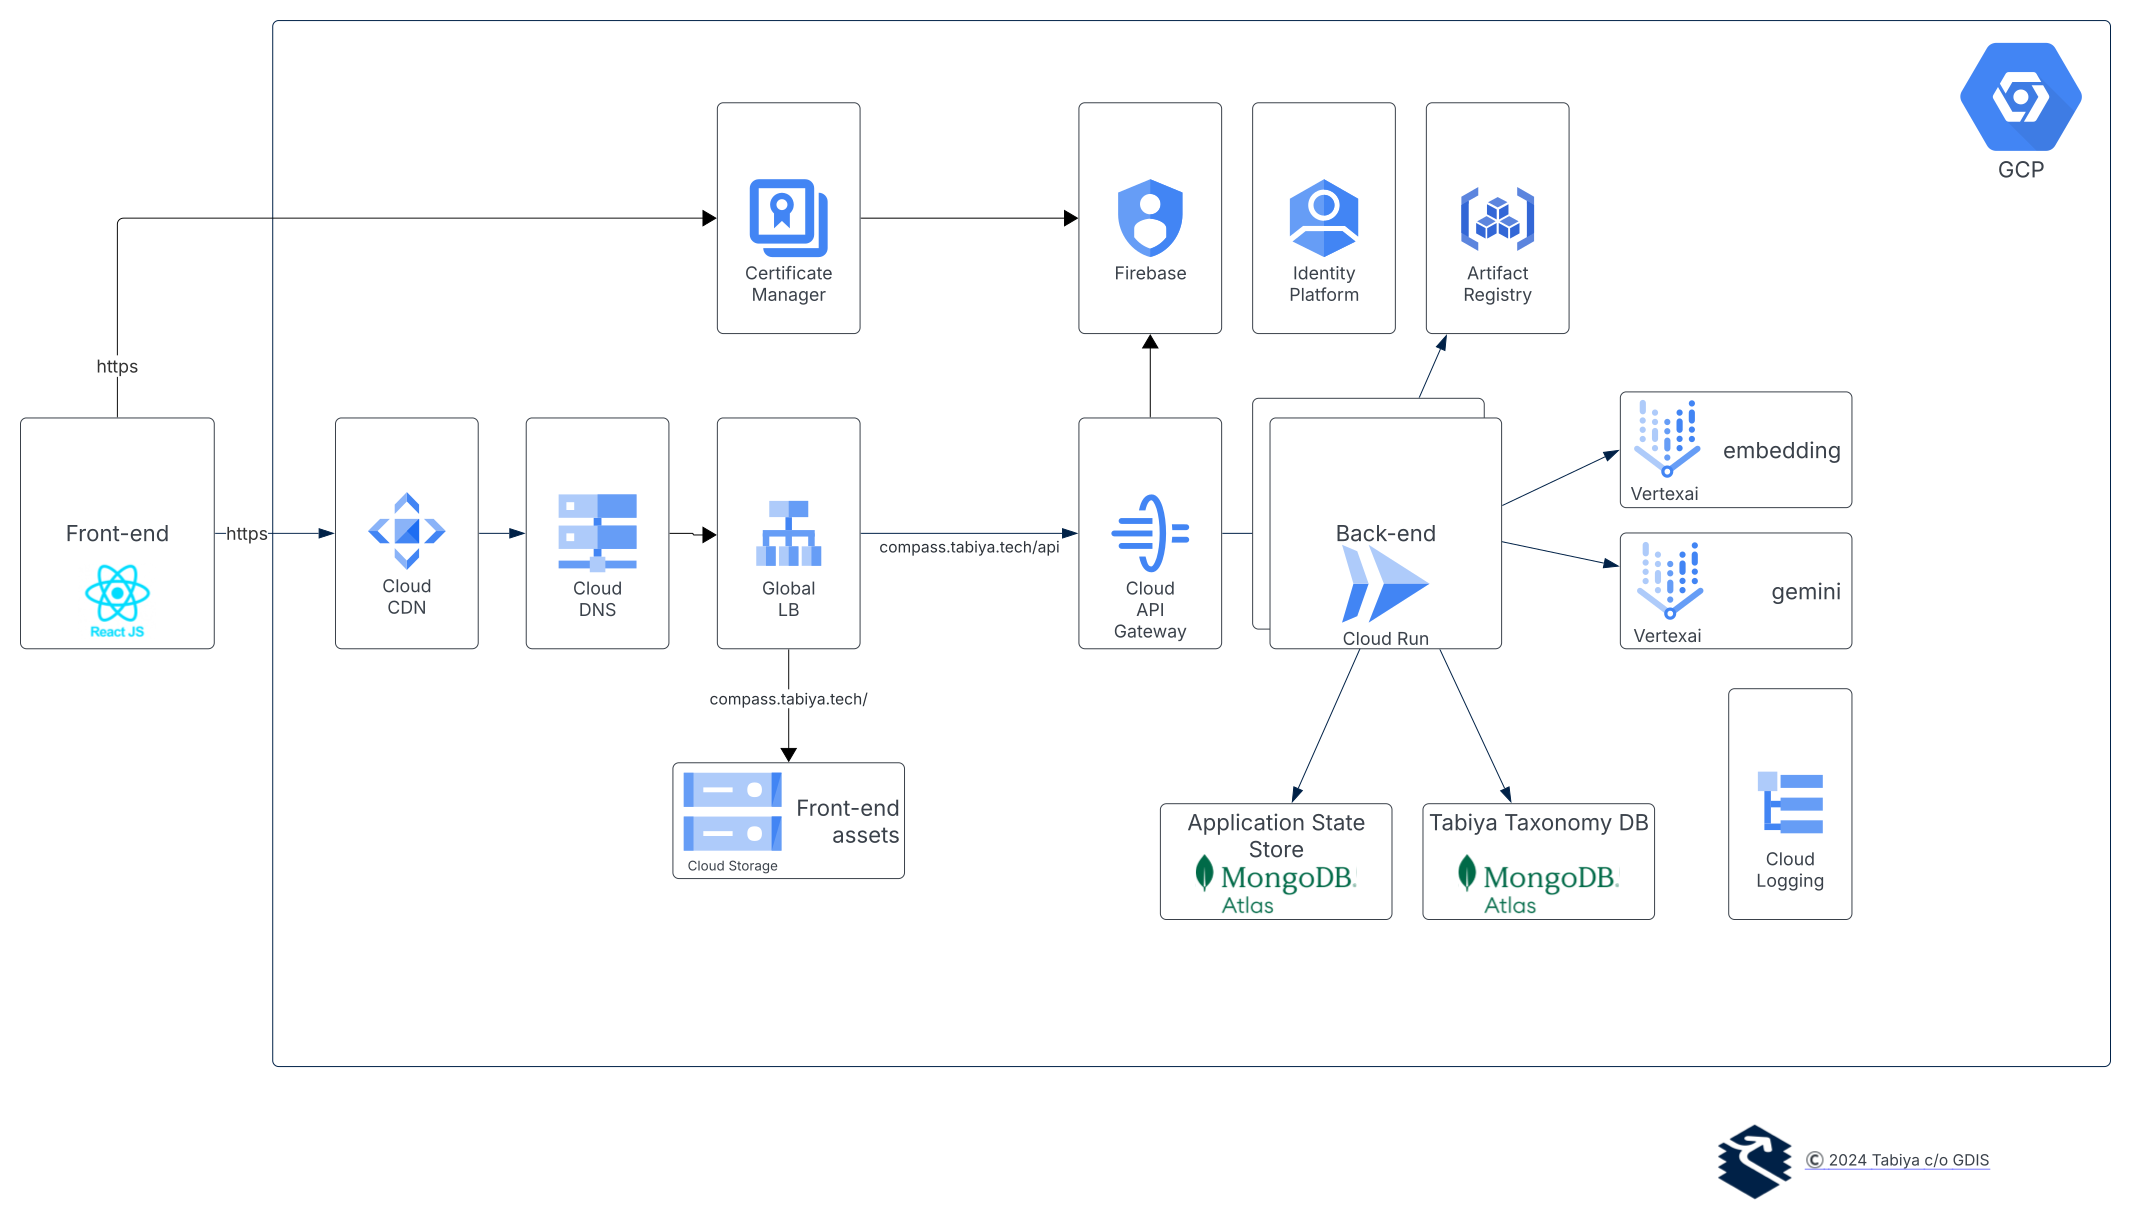
* **Sprachmodelle und Embeddings**: Kompass nutzt das `gemini-2.0-flash-001` Modell für seine LLM-Fähigkeiten und das `text-embedding-005` Modell für Embeddings. Das `gemini-2.5-pro-preview-05-06` Modell wird für den automatischen Evaluator des LLM verwendet. Das Gemini-Modell wurde wegen seiner ausgewogenen Leistung hinsichtlich Aufgabengenauigkeit, Inferenzgeschwindigkeit, Verfügbarkeit und Kosten gewählt.
* **Backend-Technologien**: Entwickelt mit `Python 3.11`, `FastAPI 0.111`, und `Pydantic 2.7` für eine performante serverseitige Umgebung. Ein asynchrones Framework eignete sich gut für den Anwendungsfall, da LLM-Inferenzendpunkte langsam sein können. Python wurde wegen seiner umfangreichen Unterstützung für KI/ML-Bibliotheken gewählt und weil es die Integration von ML-Wissenschaftlern in das Entwicklungsteam erleichterte.
* **Frontend-Technologien**: Die mit `React.js 19`, `TypeScript 5`, und `Material UI 5` erstellte UI ist für Mobilgeräte optimiert, funktioniert aber auch auf Tablets und Desktop-Computern gut. Außerdem verwenden wir `Storybook 8.1` um UI-Komponenten isoliert zu präsentieren, visuell zu prüfen und zu testen.
* **Datenspeicherung**: Daten werden sicher mithilfe von `MongoDB Atlas` gespeichert, das Vektorsuchfunktionen umfasst. Unser Team war bereits mit `MongoDB`vertraut, und die Taxonomie war bereits in `MongoDB Atlas`MongoDB, daher war es eine naheliegende Wahl.
* **Bereitstellung**: Die gesamte Anwendung ist auf `Google Cloud Platform (GCP)` bereitgestellt, was hohe Verfügbarkeit und Skalierbarkeit sicherstellt. Wir verwenden `Pulumi` für die Bereitstellung von fast der gesamten Infrastruktur, da wir damit Bereitstellungscode in `Python` schreiben können, was mit dem Rest der Backend-Entwicklung übereinstimmt. Darüber hinaus hatte unser Team bereits Erfahrung mit `Pulumi`, was es zu einer naheliegenden Wahl machte. Für das Fehler-Tracking und das Monitoring der Anwendungsleistung verwenden wir `Sentry`.
Cloud-Architektur
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.tabiya.org/tabiya-documentation/deutsch/unser-technologie-stack/compass/technical-overview.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.