> For the complete documentation index, see [llms.txt](https://docs.tabiya.org/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.tabiya.org/tabiya-documentation/es/nuestra-pila-tecnologica/compass/technical-overview.md).
# Resumen técnico
### Arquitectura de IA
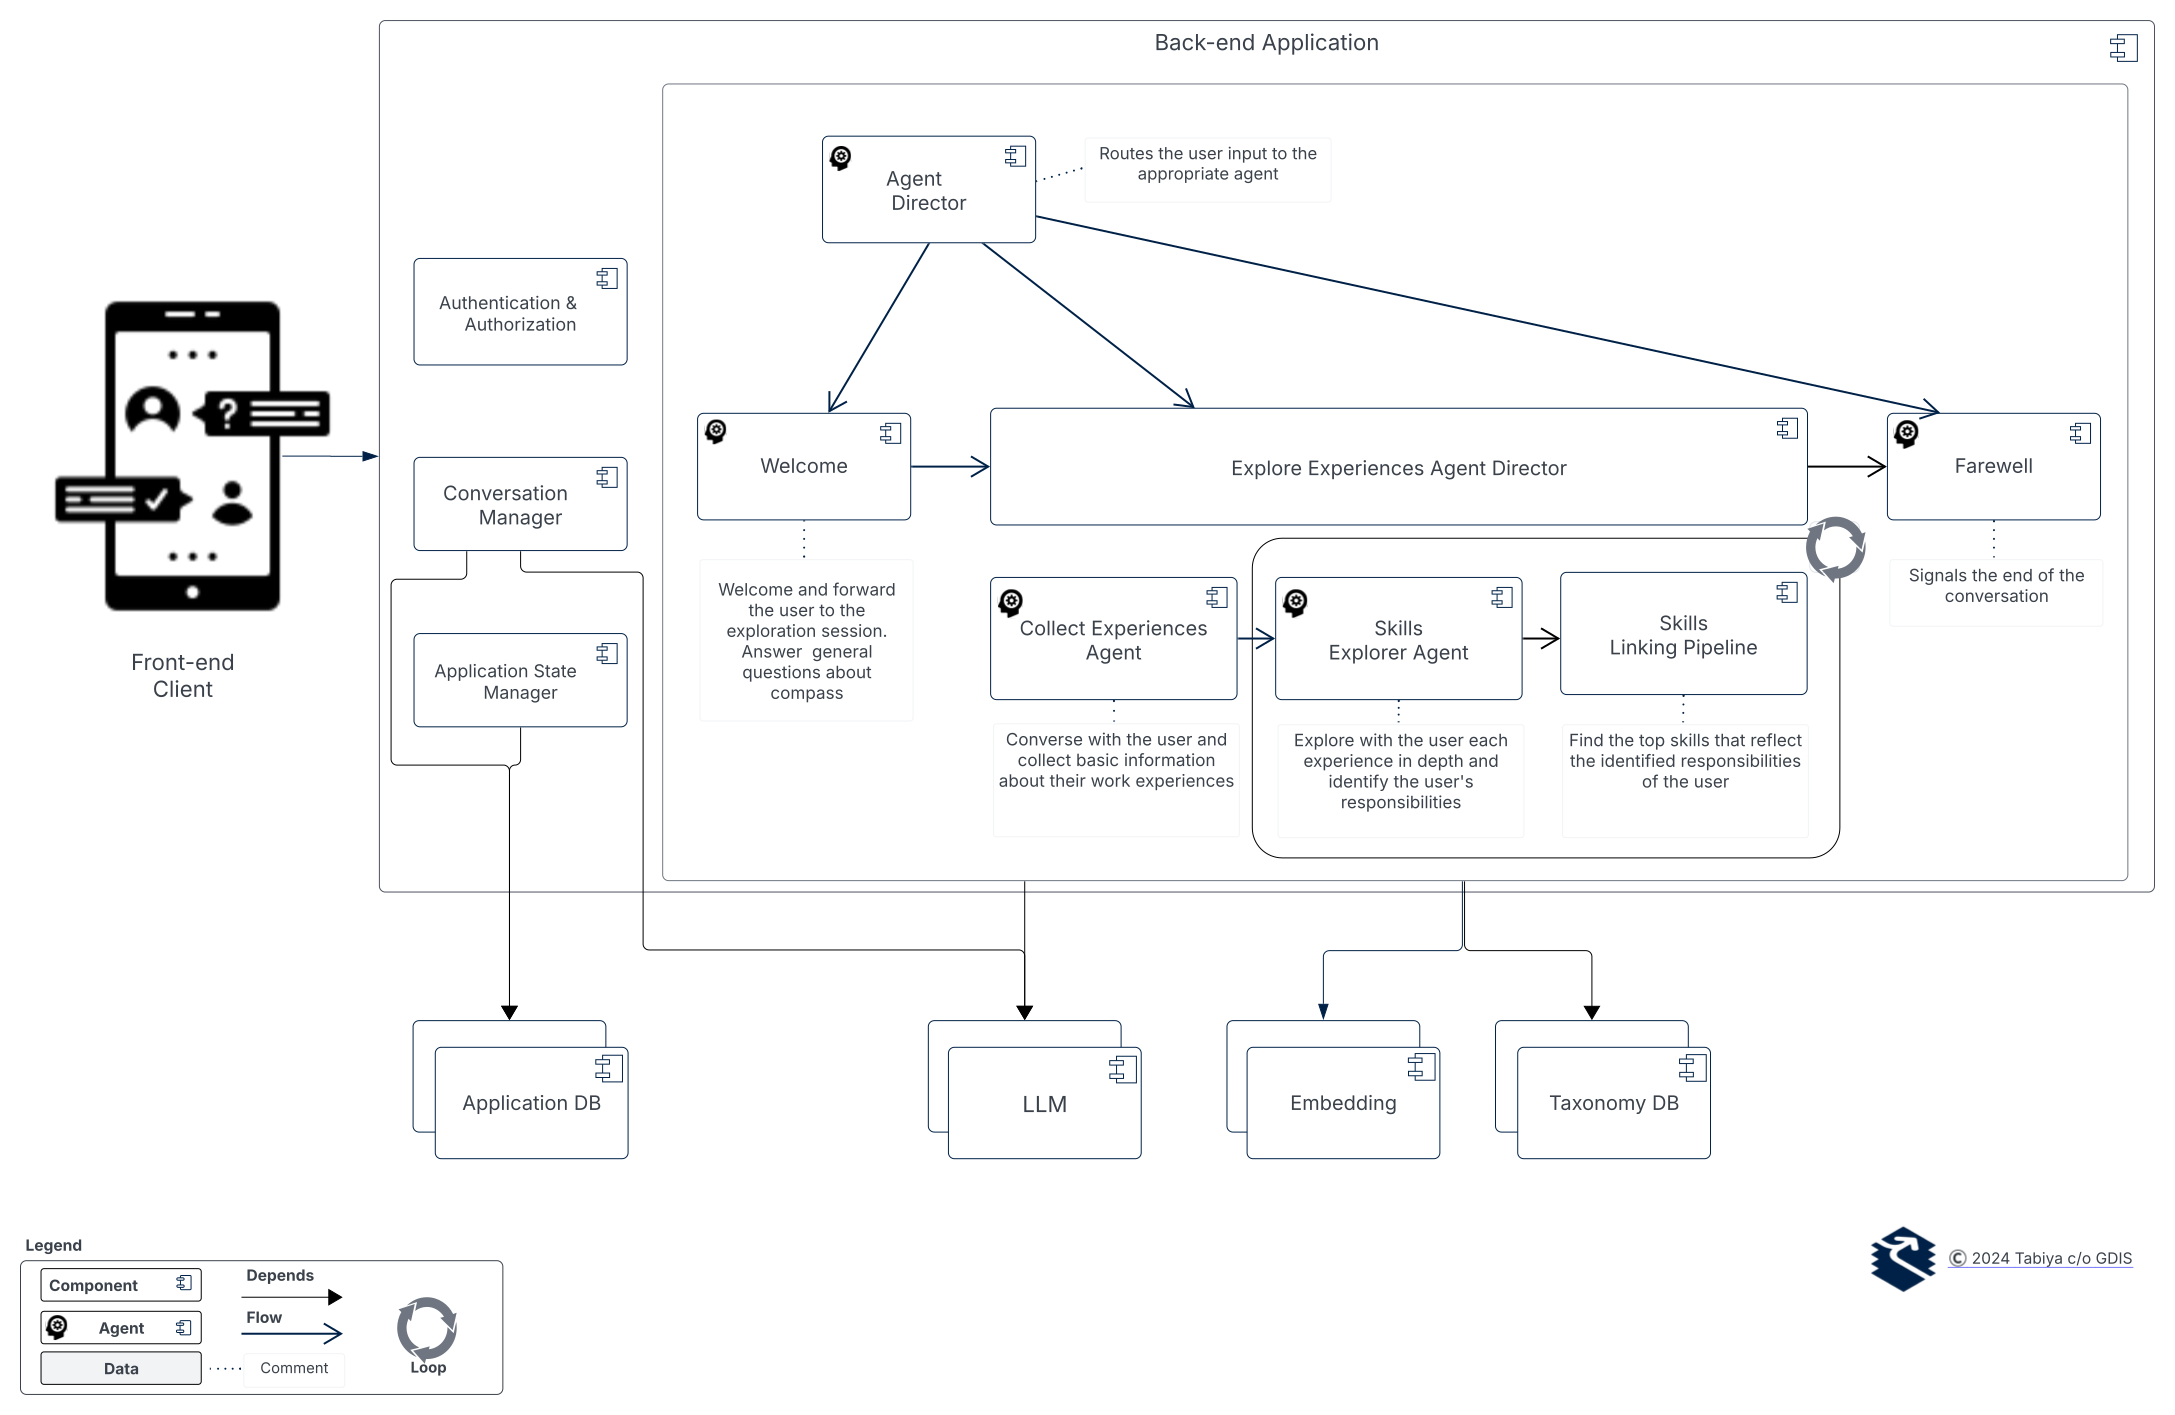
Compass utiliza flujos de trabajo agentivos para interactuar con los usuarios, recopilar información e identificar sus habilidades.
Compass imita cómo una persona abordaría una conversación y las tareas resultantes, actuando como un agente global que se descompone en agentes más pequeños, cada uno con sus propias responsabilidades y objetivos.
Cada agente dentro de Compass tiene una responsabilidad específica y realiza múltiples tareas para alcanzar su objetivo. Por ejemplo, un agente podría conversar con un usuario para recopilar información específica, procesar esa información y prepararla para que otro agente la utilice.
Descripción general de la arquitectura de IA de Compass
Los agentes mantienen un estado interno que les permite aplicar una estrategia para lograr su objetivo, y tienen acceso al historial de conversación del usuario y utilizan herramientas basadas en prompts de LLM (o no). Estas herramientas podrían usarse para tareas como conversar con el usuario, extracción de entidades nombradas, clasificación o transformación de la entrada del usuario.
Los agentes se guían por una combinación de instrucciones (prompts) y su estado interno. Los prompts pueden variar según el estado del agente para ayudarle a completar sus tareas.
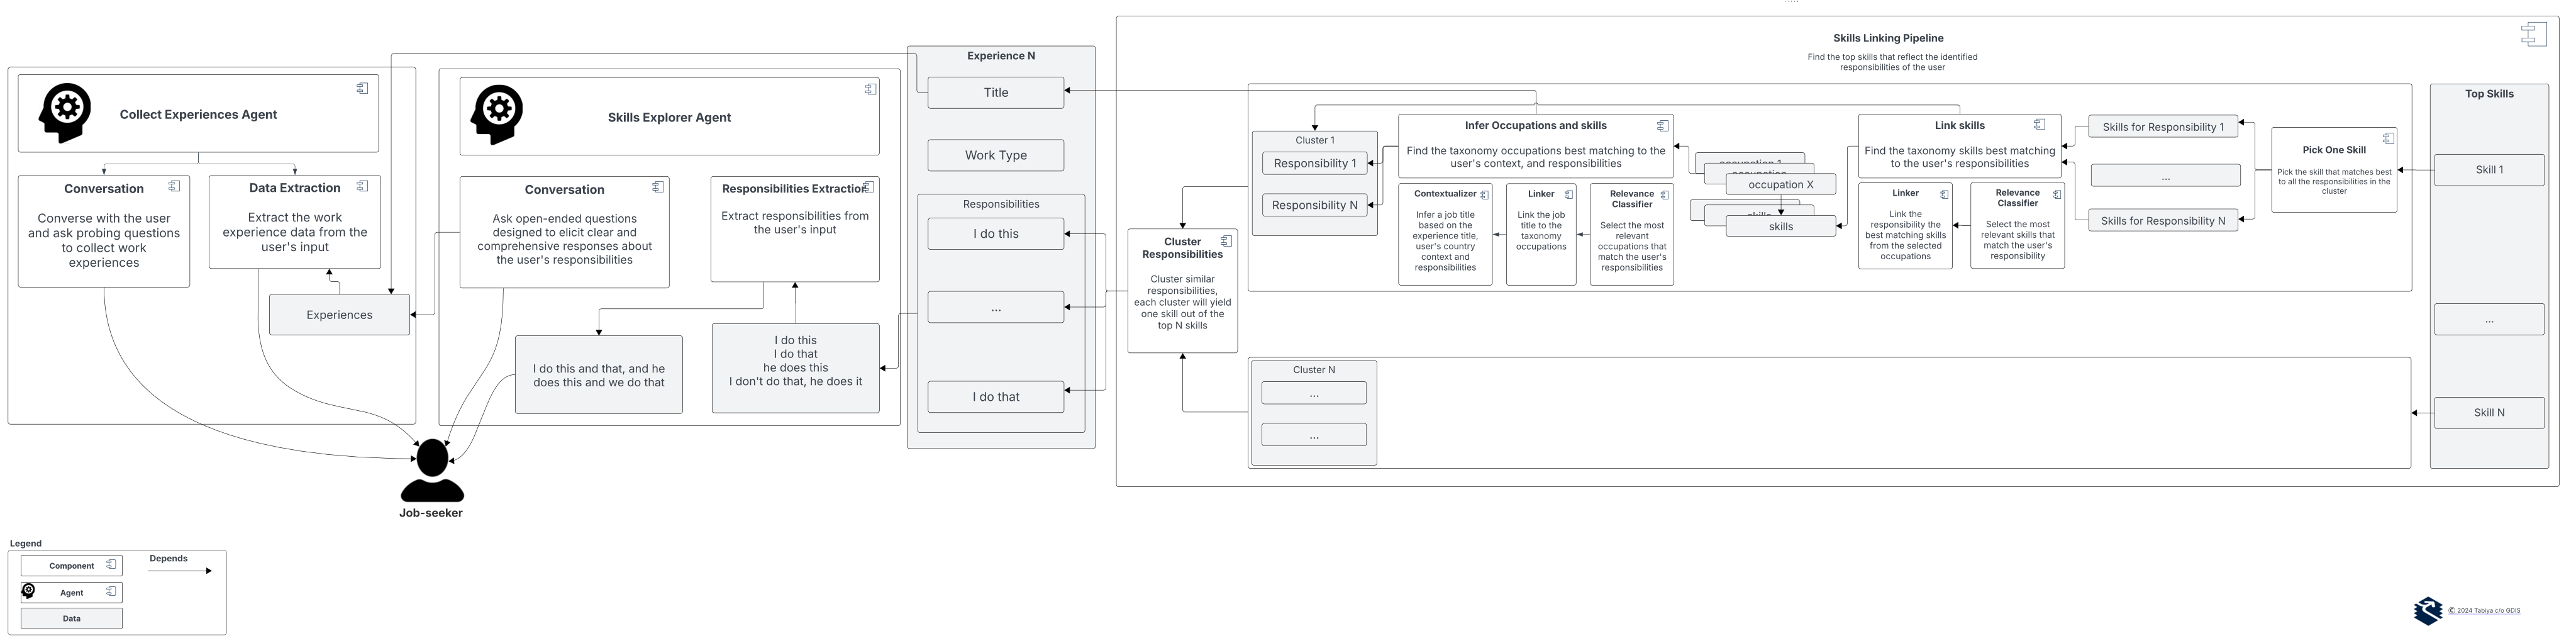
Una vez que Compass ha recopilado toda la información necesaria del usuario, procesa los datos para identificar las principales habilidades del usuario. Esta identificación se realiza mediante una canalización de varias etapas que emplea diversas técnicas, como clustering, clasificación y vinculación de entidades a una taxonomía de ocupaciones/habilidades.
Arquitectura de IA detallada con la canalización de habilidades de varias etapas
Compass aprovecha los LLM de cuatro maneras:
1. **Participación conversacional**: A diferencia de las aplicaciones típicas en las que el LLM responde a las preguntas del usuario, Compass invierte esta interacción. Genera preguntas para guiar una **dirigida** y **fundamentada** conversación.
2. **Tareas de procesamiento de lenguaje natural**: Compass utiliza el LLM para tareas como clustering, extracción de entidades nombradas y clasificación, manejando las entradas del usuario de forma eficiente sin necesidad de costosos y lentos entrenamientos o ajustes finos del modelo.
3. **Explicabilidad y trazabilidad**: El LLM proporciona razonamiento para resultados específicos, lo que permite explicaciones que vinculan las habilidades descubiertas con la entrada del usuario. Esta función, basada en una variación del razonamiento de Cadena de pensamiento, es especialmente destacable, no solo por la capacidad que ofrece, sino también porque fue un resultado no previsto. Surgió al intentar resolver un problema distinto: mejorar la precisión de las tareas del LLM
4. **Filtrado de la salida de la taxonomía**: El LLM filtra las habilidades y ocupaciones relevantes conectadas al modelo ESCO a partir de la salida de la conversación. Aprovechando sus capacidades avanzadas de razonamiento, el LLM procesa eficientemente grandes cantidades de texto, identificando las entidades más pertinentes. Este enfoque combina la vinculación tradicional de entidades mediante búsqueda semántica con un filtrado basado en LLM, creando una solución híbrida.
Compass está fundamentado y protegido de alucinaciones de varias maneras:
* **Descomposición de tareas**: Se asignan tareas más pequeñas y manejables a agentes individuales con prompts de LLM específicos.
* **Instrucciones inducidas por el estado**: Los agentes utilizan su estado interno para generar instrucciones específicas durante las interacciones con el usuario, guiando la conversación hacia un objetivo concreto. Este enfoque reduce el tamaño del prompt al incluir solo segmentos relevantes, lo que hace más probable que el LLM siga las instrucciones con precisión y, por ende, reduce el riesgo de alucinaciones.
* **Salida guiada**: Las instrucciones se elaboran cuidadosamente para aumentar la probabilidad de respuestas relevantes. Las técnicas incluyen:
* aprendizaje de uno y pocos ejemplos
* Cadena de pensamiento
* Generación aumentada por recuperación
* esquemas JSON con validación y reintentos
* Ordenar los segmentos de salida para alinearlos con dependencias semánticas
* **Salvaguardas de estado**: Siempre que es posible, se toman decisiones sencillas basadas en reglas, reduciendo la dependencia del LLM y minimizando posibles inexactitudes.
* **Fundamentación en la taxonomía**: Al vincular las entidades a una taxonomía predefinida de ocupaciones/habilidades, Compass garantiza que las habilidades identificadas permanezcan dentro de un dominio relevante y preciso.
### Evaluación
Para evaluar Compass, seguimos la estrategia descrita a continuación:
* **Evaluación rigurosa de embeddings**: Evaluamos rigurosamente varias estrategias para generar embeddings a partir de las entidades de la taxonomía. Entre nuestras consideraciones estuvieron identificar qué propiedades de las entidades debían incluirse en la generación de embeddings, así como determinar el número óptimo de entidades para equilibrar precisión y exactitud. Para las pruebas, utilizamos conjuntos de datos consolidados de la literatura y generamos datos sintéticos para imitar consultas de usuarios de Compass.
* **Pruebas aisladas de componentes**: Las herramientas de cada agente se evaluaron individualmente utilizando entradas específicas y salidas esperadas. Por ejemplo, los componentes de clasificación se probaron con entradas conocidas para verificar una asignación correcta de etiquetas.
* **Conversaciones guionizadas**: Los agentes conversacionales se probaron mediante diálogos predefinidos, y las salidas se evaluaron mediante evaluadores automatizados (otros LLM) o inspectores humanos.
* **Interacciones de usuario simuladas**: Compass se probó en escenarios de extremo a extremo simulando interacciones de usuarios impulsadas por un LLM. Al usuario simulado se le asignó una persona basada en nuestra investigación de UX e instrucciones adicionales para cubrir casos específicos de interés. Luego, estas conversaciones fueron evaluadas por su calidad y relevancia mediante evaluadores automatizados (otros LLM) o inspectores humanos.
* **Pruebas con usuarios y análisis de trazas**: A menor escala, se realizaron pruebas con usuarios reales. Al trazar la correspondencia entre las principales habilidades de salida y la entrada del usuario, los inspectores humanos pudieron evaluar el rendimiento de agentes específicos dentro de Compass.
### El papel central de una taxonomía
La taxonomía inclusiva de Tabiya desempeña un papel central en Compass. Fundamenta las tareas del LLM, pero hay varios aspectos adicionales que vale la pena mencionar:
* **Estandarización**: Las habilidades identificadas se vinculan a una taxonomía estándar, lo que facilita la interpretación y la comparación. Los conceptos detrás de estas habilidades están bien definidos y pueden explicarse, lo que permite aclararlos y desambiguarlos.
* **Canonización**: Las habilidades exploradas se enumeran con nombres canónicos y UUID, lo que permite una referencia consistente entre distintas experiencias y aplicaciones.
* **Estructura de red**: La taxonomía modela el mercado laboral asociando ocupaciones con habilidades, formando un grafo de conocimiento que puede proporcionar información adicional a los usuarios.
* **Economía invisible**: La taxonomía se ha ampliado para incluir actividades de la economía invisible, empoderando a mujeres jóvenes y a quienes buscan empleo por primera vez para entrar en el mercado laboral.
* **Localización**: Una taxonomía puede considerar el contexto específico de un país. Esto incluye ocupaciones exclusivas de ciertas regiones, nombres alternativos para ocupaciones que son específicos de la región y distintos requisitos de habilidades para la misma ocupación en diferentes países.
* **Clasificación del tipo de trabajo**: Todas las experiencias se clasifican en cuatro tipos (empleo asalariado, trabajo por cuenta propia, trabajo de aprendiz no remunerado y trabajo invisible), lo que permite una exploración más focalizada de las habilidades del buscador de empleo.
### Resumen de la pila tecnológica
* **Modelos de lenguaje y embeddings**: Compass utiliza el `gemini-2.0-flash-001` modelo para sus capacidades de LLM y el `text-embedding-005` modelo para embeddings. El `gemini-2.5-pro-preview-05-06` modelo se utiliza para el autoevaluador del LLM. El modelo Gemini fue elegido por su rendimiento equilibrado en precisión de tareas, velocidad de inferencia, disponibilidad de tasa y costo.
* **Tecnologías de backend**: Desarrollado con `Python 3.11`, `FastAPI 0.111`, y `Pydantic 2.7` para un entorno del lado del servidor de alto rendimiento. Un marco asíncrono se ajustó bien al caso de uso, ya que los endpoints de inferencia de LLM pueden ser lentos. Se eligió Python por su amplio soporte de bibliotecas de IA/ML y porque facilitó la integración de científicos de ML en el equipo de desarrollo.
* **Tecnologías de frontend**: La interfaz de usuario, construida con `React.js 19`, `TypeScript 5`, y `Material UI 5`, está optimizada para móviles pero funciona bien en tabletas y computadoras de escritorio. Además, utilizamos `Storybook 8.1` para mostrar, inspeccionar visualmente y probar componentes de la interfaz de usuario de forma aislada.
* **Persistencia de datos**: Los datos se almacenan de forma segura utilizando `MongoDB Atlas`, que incluye capacidades de búsqueda vectorial. Nuestro equipo ya estaba familiarizado con `MongoDB`, y la taxonomía ya estaba en `MongoDB Atlas`él, así que fue una elección natural.
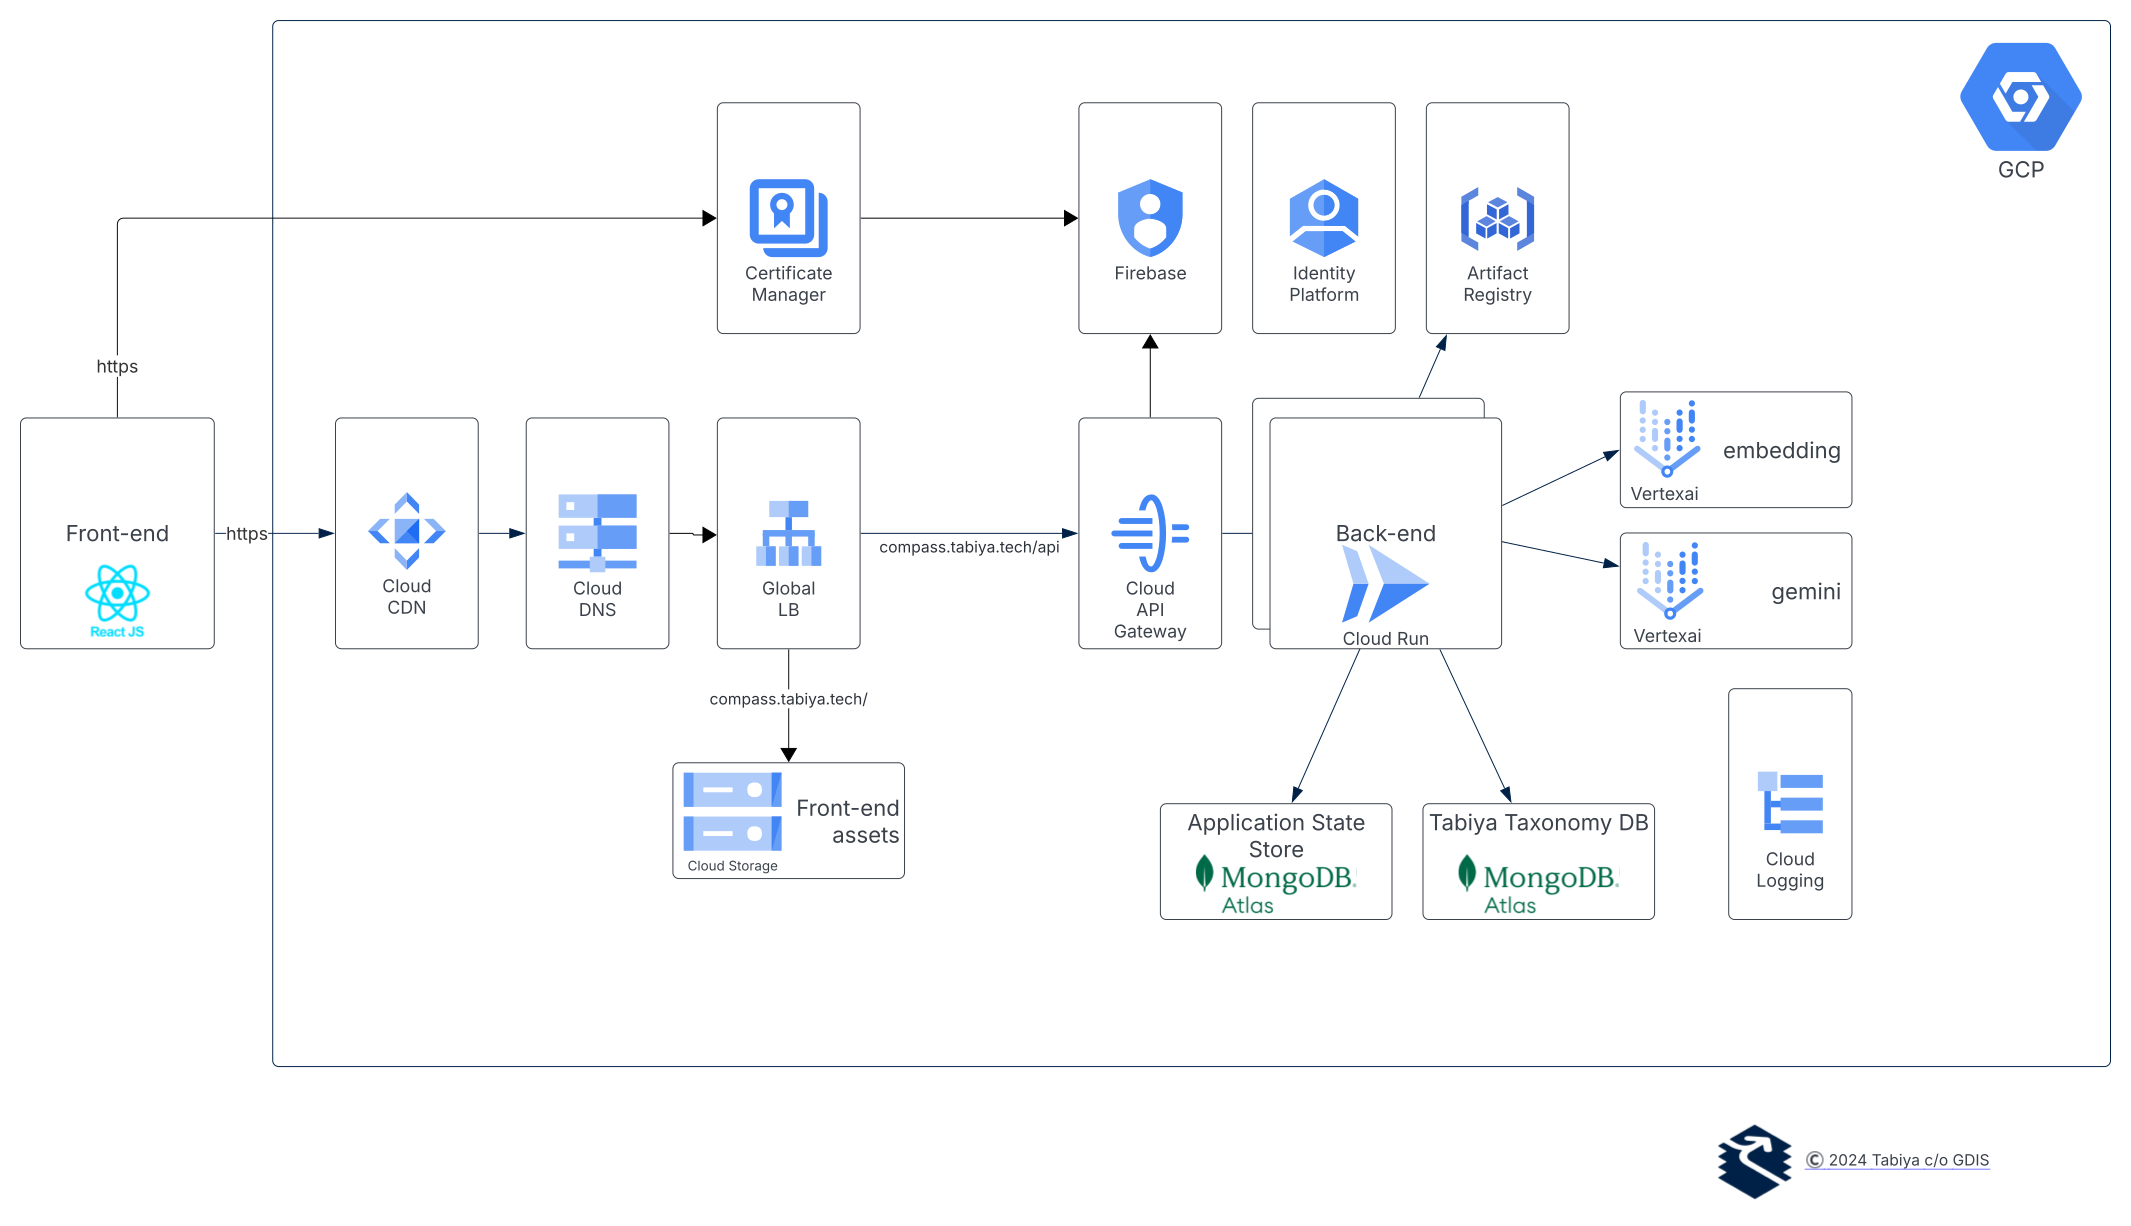
* **Despliegue**: Toda la aplicación está desplegada en `Google Cloud Platform (GCP)`, lo que garantiza alta disponibilidad y escalabilidad. Utilizamos `Pulumi` para desplegar casi toda la infraestructura, ya que nos permite escribir el código de despliegue en `Python`, alineándose con el resto del desarrollo del backend. Además, nuestro equipo ya tenía experiencia con `Pulumi`, lo que lo convierte en una elección natural. Para el seguimiento de errores y la supervisión del rendimiento de la aplicación, utilizamos `Sentry`.
Arquitectura en la nube
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.tabiya.org/tabiya-documentation/es/nuestra-pila-tecnologica/compass/technical-overview.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.